RAM vs CPU: miért fontosabb a memória a számítási teljesítménynél?
Mi történik valójában, amikor az AI gondolkodik?
Ha számítógép-teljesítményről van szó, általában a processzorra gondolunk: „hány GHz? hány mag?” Ez logikus sok feladatnál — videóvágás, játék, összetett táblázat futtatása…
Egy ArkeoAI-hoz hasonló nyelvi modell futtatásánál azonban ez a logika teljesen megfordul. Nem a processzor sebessége dönti el, hogy működik-e a rendszer — hanem az elérhető RAM mennyisége. A különbség nem elhanyagolható: egy modell egyszerűen megtagadhatja az indítást, ha a RAM nem elegendő, függetlenül a CPU sebességétől.
Lássuk, hogy miért.
Egy AI-modell mindenek előtt egy óriási adatcsomag
Egy olyan nyelvi modell, mint a Mistral, a LLaMA vagy a Gemma, nem hagyományos program. Matematikai paraméterek fájlja — tulajdonképpen milliárdnyi szám —, amelyek mindazt kódolják, amit a modell „tud”. Ezek a számok csillagászati mennyiségű szövegen végzett tanulás eredményei.
Ezeknek a fájloknak a mérete közvetlenül arányos a modell képességével. Egy kis, 7 milliárd paraméteres (7B) modell körülbelül 4–8 GB-ot nyom. Egy képesebb, 13 milliárd paraméteres modell (13B) könnyen meghaladja a 10–16 GB-ot. A nagy, 70 milliárd paraméteres modellek (70B) elérhetik a 40–60 GB-ot.
Ennek a nyers adatmennyiségnek valahol el kell férnie a futás alatt. Ez a hely pedig csakis a RAM lehet.
Miért kell mindennek a RAM-ban elférnie?
A processzor nem tárol semmit — csak számít
A processzor (CPU) feladata a számítások elvégzése: összeadások, szorzások, összehasonlítások. Nagyon gyors, de semmit nem tárol. Egy számítás elvégzéséhez a memóriából kell adatot hoznia, feldolgozni, majd visszaadnia az eredményt.
Képzeljünk el egy szakácsot a konyhában. A processzor a szakács. Villámgyorsan tud hámozni, vágni és kevereni. De nem tarthat a kezében egyszerre 40 kilónyi hozzávalót. Szüksége van egy elegendően nagy munkafelületre, hogy mindent kézzel elérhető közelségbe találjon.
Ez a munkafelület a RAM.
A merevlemez problémája: a sebesség
Felmerülhet a kérdés: ha a modell nem fér el a RAM-ban, miért ne használjuk a merevlemezt? Technikailag lehetséges — ezt hívják swapnak vagy lemezre végzett offloadingnak. A gyakorlatban azonban ez szinte használhatatlan.
Egy hagyományos merevlemez (HDD) körülbelül 100 000-szer lassabb egy RAM-sávnál az adatok elérésekor. Még egy gyors NVMe SSD is 10–50-szer lassabb a RAM-nál. Egyetlen válaszszó generálásához a modellnek tízezerszer kell a saját paramétereibe nyúlnia. Ha minden egyes hozzáférés lemezről való adatbetöltést igényel, a késedelem elviselhetetlenné válik.
Konkrét eredmény: egy részben lemezen tárolt modell perceket vehet igénybe egyetlen mondat generálásához. Ez már nem asszisztens — ez várakozás.
Mi történik konkrétan egy inferencia során?
Amikor kérdést teszünk fel az AI-nak, leegyszerűsítve ez történik technikailag:
- A kérdést tokenizálják — kis szövegegységekre, tokenekre bontják.
- Ezeket a tokeneket numerikus vektorokká alakítják.
- Ezek a vektorok áthaladnak a modell rétegein — több tíz, néha száz mátrixszámítási rétegen. Minden réteg a modell adatainak egy részét használja.
- Minden réteg kimenetét a következő réteg bemenetként használja.
- A folyamat végén a modell egy válasz-tokent állít elő. Aztán újrakezdi a következő tokennel, és így tovább, egészen a válasz végéig.
Minden lépésnél a processzornak hozzá kell férnie az aktuális réteghez tartozó adatokhoz. Ha ezek az adatok nincsenek a RAM-ban, a lemezről kell betölteni őket — és minden megáll. Az egész modellnek be kell töltődnie a RAM-ba, mielőtt az első válasz egyáltalán elkezdene megjelenni.
A CPU nem felesleges — csak nem ez a lényeg
Ez nem jelenti azt, hogy a processzor nem számít. Valóban ő végzi el az egyes rétegek matematikai műveleteit — és egy gyorsabb vagy erősebb CPU a modell betöltése után gyorsabban állít elő tokeneket.
De íme a valódi prioritási sorrend egy LLM futtatásához normál számítógépen:
- 1. prioritás — Elegendő RAM: enélkül a modell nem indul el, vagy használhatatlanná válik.
- 2. prioritás — Memória-sávszélesség: az a sebesség, amellyel a CPU a RAM-ot olvassa, ugyanannyit számít, mint maga a processzorfrekvencia.
- 3. prioritás — CPU sebesség: a modell megfelelő betöltése után növeli a másodpercenkénti token-átviteli sebességet.
Ezért olyan hatékonyak a GPU-k (grafikus kártyák) az AI-modelleknél: beépített memóriájuk (VRAM) van kivételesen magas sávszélességgel, amely képes a modell adatait olyan sebességgel szállítani a grafikus processzorhoz, amelyet egy hagyományos RAM-mal rendelkező normál CPU nem tud utolérni.
Mennyi RAM kell valójában?
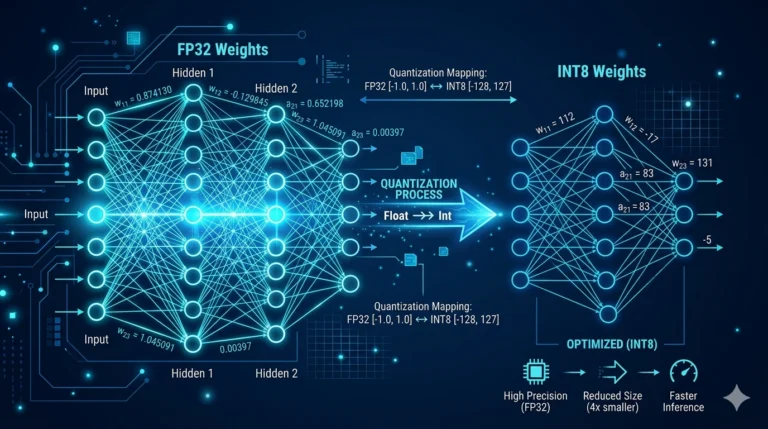
Gyakorlati ökölszabály a RAM-igény becsléséhez: számoljunk körülbelül 1 GB RAM-ot milliárd paraméterenként, 4-bites formátumú kvantált (tömörített) modellek esetén. Kevésbé agresszív tömörítésnél (8-bit) kétszerezd meg ezt az értéket.
- 7B-s modell, 4-bites kvantálás: körülbelül 4–5 GB RAM — fut egy 8 GB RAM-os normál asztali számítógépen.
- 13B-s modell, 4-bites kvantálás: körülbelül 8–10 GB — 16 GB RAM szükséges a kényelmes működéshez.
- 34B-s modell, 4-bites kvantálás: körülbelül 20 GB — legalább 32 GB RAM szükséges.
- 70B-s modell, 4-bites kvantálás: körülbelül 40 GB — 64 GB vagy több szükséges.
Ezért az ArkeoAI által használt mini PC-ket minimum 32, de néha 64 GB RAM-mal konfiguráljuk — nem óvatosságból, hanem funkcionális szükségszerűségből. Ez teszi lehetővé, hogy komoly szakmai felhasználásra kellőképpen képes modelleket futtassunk, internet nélkül, az adatok kiküldése nélkül.
Összefoglalás
Egy nyelvi modell mindenekelőtt egy óriási adattömeg, amelyet a memóriában kell tartani. Mielőtt bármit kiszámítana a modell, az összes paraméternek azonnal elérhetőnek kell lennie — és csak a RAM kínálja ehhez a szükséges sebességet.
Egy gyors processzor túl kevés RAM-mal olyan, mint egy versenyszakács egy munkafelület nélküli konyhában: lehet a legügyesebb kezű szakember a világon, mégsem tud dolgozni. Ezzel szemben egy sok RAM-mal és szerényebb CPU-val rendelkező gép lassabb válaszokat ad — de képes jó válaszokat adni.
A RAM tehát a szükséges feltétel. A CPU sebesség az optimalizáláshoz kell. Ebben a sorrendben, és nem fordítva.